


Recursos didácticos de Machine Learning: Series Temporales III. Modelos
Con esta parte finalizo la sesión dedicada a Series Temporales donde se ha construido desde un artilugio para recoger datos atmosféricos dados en mi jardín, la visualización de algunos de estos datos y ahora, con una muestra que va desde el 22 de Febrero hasta el 17 de Abril del 2026, me dispongo a tratar de crear algún modelo sencillo y a comparar los resultados con datos oficiales recogidos por la estación meteorológica de Pinar de Chamartín que está cerca de donde yo vivo.
Por tanto, voy a tratar de ser ordenado porque se va a trabajar con 2 tipos de información:
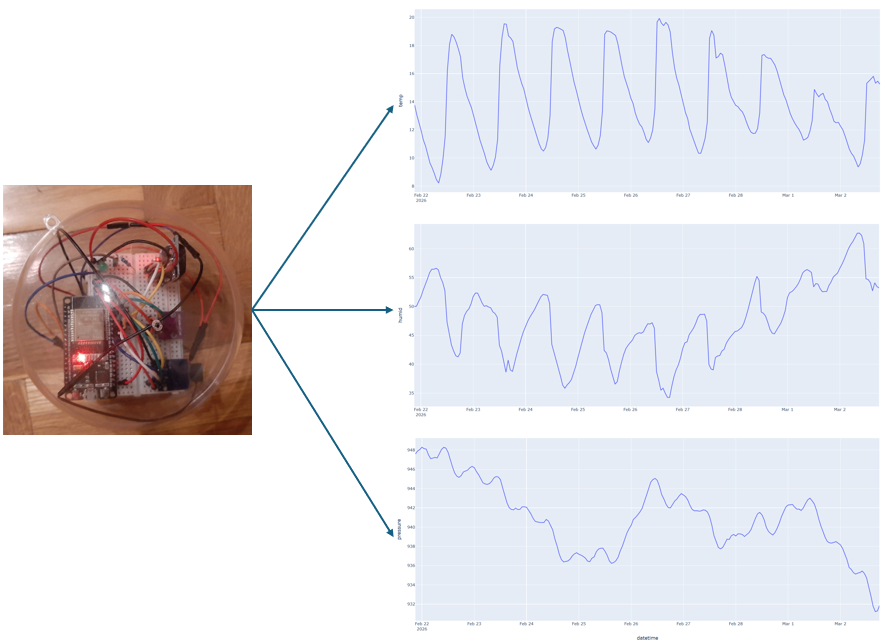
Información tipo I Mis propios datos donde hay sólo 3 variables que son temperatura, humedad y presión todas medidas cada 10 minutos y cuyo aspecto resulta ser el siguiente:

Información tipo II: Por otro lado para determinar la variable target y para hacer otras comparaciones, me he descargado la información de la estación meteorológica de https://meteostat.net/es/ donde puedes definir unas fechas y te descargas una serie de variables entre ellas estarían, a nivel diario varias de las que voy a considerar sólo las siguientes: la precipitación, la temperatura media y la presión media. No tomo la humedad, porque no existe esa variable (aunque se dan otras como la velocidad del viento y demás que por motivos de comparabilidad con los datos que tengo, no la usaré aquí aunque puseda ser relevante para un modelo más sofisticado) Así pues represento a continuación para el mismo período de antes la evolución de la temperatura y la presión media de los datos que se denominarán "oficiales" en este estudio:

Si se observa las variables comunes y consideradas son parecidas en comportamiento general, si bien cambian la escala de medición, sobre todo en el caso de la presión. En todo caso, la variable target sale del dato de precipitaciones que da la estación meteorológica considerada de modo que, si existe un valor de precipitación > 0 entonces target = 1 y en caso contrario target = 0 teniéndose por tanto 2 datasets con las siguientes estructuras:

En este caso las variables explicativa son: tmean_l1, pmean_l1, y hmeanl1 (siendo esta última sólo disponible en el dataset de "datos propios" no oficiales) mientras que la variable explicada en ambos conjuntos es target.
Por simplificar este análisis no se han añadidoi variables adicionales que podría por ejemplo extraer en mi caso como variaciones intra-dia, y en el caso de los datos oficiales podría haber considerado otras variables adicionales como ya he comentado, dejamos por tanto estas variables comunes para construir algunos modelos y ver qué es lo que pasa en tan corto período de tiempo.
Si se comienza analizando el dataset de mis propios datos bajo un modelo de regresión logística donde se usa el 90% de la información de las series temporales para entrenar y un escalado de las variables tal como sigue:

Se llegan a plantear los siguientes modelos:
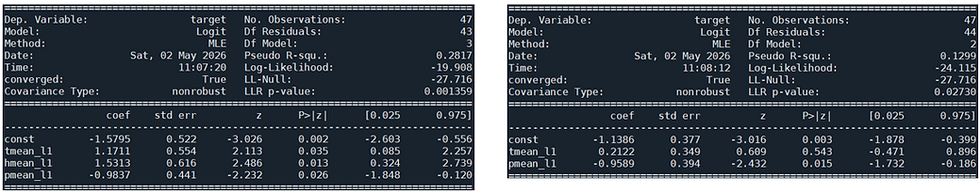
En este caso se observa el hecho curioso de que si se elimina la variable hmean_l1 que es la variable que mide la media de la humedad del día anterior (y que no existe en el dataset anterior), entonces sólo la variable pmean_l1 o media de la presión del día anterior se torna como significativa. No obstante en ambos casos los signos de la regresión tal y como se puede observar resultan correctos y de interpretación directa.
¿Qué ocurre cuando se plantea el modelo con datos oficiales? En este caso se obtiene el siguiente resultado tras aplicar el mismo proceso:

En este caso el resultado, a nivel de conclusiones también indica que la variable tmean_l1 llega a ser superflua y no aporta significatividad al modelo, por lo que tanto con datos oficiales como con datos propios se llega a la conclusión que todo el mundo conoce y es que "bajas presiones anticipan lluvias, mientras que las altas presiones anticipan estabilidad o más bien ausencia de lluvia", sin embargo resulta curioso como la medición de la humedad está introduciendo un factor que usado junto con la temperatura permite un modelo con más variables significativas, por tanto, se van a considerar los siguientes 3 modelos que se denominarán "completo con datos propios", "común con datos propios" y "común con datos oficiales" todos con variables significativas tal y como se observa a continuación:

En todos los caso se observa que para el único día en el que hubo lluvia los modelos aciertan, mientras que mantienen elevada la probabilidad de lluvia para el día siguiente. También se observa en los "modelos comunes" que la significatividad de la variable presión media del día anterior tiene una significatividad parecida, si bien es cierto que la coherencia a nivel predictiva es mayor en el modelo con "datos oficiales" frente al de "datos propios"
En todo caso para ampliar las pruebas podría discutirse otros modelos como decision tree o incluso random forest. En los códigos de "versiones modelos" que cuelgo en el git:
Hay código para que adecuadamente modificado se pueda testear estas opciones con todas o parte de las variables, esa discusión no se hace aquí, pero resultaría interesante analizar al menos la actuación de los decision trees ya que para ir a un random forest sería recomendable un mayor volumen de información.
Por otro lado, el hacer uso de datos "intradía" nos podría permitir incluso usar más variables que desde un medio "oficial" no se nos daría al menos que se pagase por ellos, en el supuesto que lo tuvieran, por tanto, como conclusión finales caben destacar los siguientes:
Se ha logrado crear modelos que se podrían llevar a un entorno productivo bajo un proceso de retro alimentación continua que permitiesen un machine learning real mejorando la fiabilidad de las predicciones cuando se dispusiese de más datos con los que se podría crear de un modo sencillo un modelo que "aprendiese" de los datos
La información "oficial" es susceptible de ser completada con información "particular" como es el caso de la variable humedad y otras que se podrían crear basados en comportamientos intra día que pudieran influir en el comportamiento del día siguiente, por ejemplo "media de presiones durante las 6 horas previas al inicio del siguiente día"
Aunque ambos modelos parecen equivocarse en que en el día siguiente a la ocurrencia de la lluvia, debería haber llovido, no se tiene con certeza si fue un error o si la lluvia tuvo lugar durante unas horas que podrían ser consideradas cercanas o ya en el día siguiente, por tanto, es un error en este caso admisible
Por último se habría de tratar un poco sobre el ajusta de las "probabilidades de lluvia", aquí no se ha tratado mucho, pero convendría ir midiendo conforme pasa el tiempo cómo ajustar esas probabilidades a datos que permitan construir un sistema semafórico tipo rojo, amarillo, verde que indique mayor o menor riesgo de lluvia
Finalmente indicar, que frente a la moda de crear post basados en chat-gpt todo lo escrito aquí es totalmente personal si bien para el tema de los códigos que elevo, si he hecho uso de la IA donde en parte considero que me ha ayudado, si bien he tenido que estar muy pendiente de correcciones y errores graves que cometía a un nivel de versión avanzada.


Comentarios