top of page

COSAS VEREDES

fjroar
20 sept
3 min de lectura

Aunque es posible que me caiga alguna leche por un amante exacerbado de la IA y de las últimas tendencias que parecen que van a acabar con toda la humanidad, a estas altura de la vida y no me preguntéis ¿Por qué me ha dado por estudiar algo de Griego Clásico? Ya sabéis, esa lengua muerta que quien bien me conoce, odiaba en la secundaria y que ahora, como ya me dijo un profesor en su momento, me arrepiento de no haberla aprendido más cuando tenía más energía pero ... nunca es tarde.


Bajo este contexto me encontraba haciendo unos ejercicios y dado que no tengo aún a mano un buen diccionario decidí usar a Chat GPT para tal función, es decir, lo único que tenía que hacer era darme, cuando yo no conociera la palabra su traducción al español sin más, y yo ya me encargaba de darle el sentido a la frase, para ello además le pasaba palabra por palabra como si estuviera haciendo una búsqueda en diccionario porque estas herramientas siempre tienen la puñetera tentación de hacerte el trabajo y no dejarte pensar.


Pues bien, me encuentro ante la siguiente oración griega, nivel super básico, que tranquilos, en breve sabréis lo que significa:


ὁ καιρὸς μεταφέρει τὰ ἔργα


Y dado que no conocía las palabras que la integran pregunto a la citada IA y me va respondiendo lo siguiente:


Claramente un alumno "poco aventajado" como yo traduciría lo siguiente:


El momento traslada las obras


Aunque preferirí darle el sentido: "El momento mueve las obras"


Y ciertamente, está mal ya que la solución que se propone en el libro "Manual de Griego Clásico" de la UNED es totalmente distinta, sería la siguiente:


La oportunidad trastoca las cosas


Conviene fijarse que no tiene nada que ver el sentido de esta solución con la dada, ya que se refiere a algo como un concepto, el de "oportunidad" que "cambia".


Por tanto me dio a ver qué pasaría si las IAs que tengo a mano hicieran la traducción y me encuentro lo siguiente:


  • En el caso de chat gpt, de la que se dice haber demostrado el teorema de Naviër-Stokes, se tendría:


  • Mientras que análogo resultado se obtiene con Gemini:


  • Si bien es cierto que Claude, esos que van a acabar con la humanidad, dice que "quiere contexto", ¡Nos ha jodido Mayo con la flores! y yo también pero no lo tengo y tengo que elegir una traducción coherente, pero apoya un resultado que se aleja del correcto claramente:


En este caso da unas pistas de posibles otras traducciones pero tajantemente afirma

que la que propone es la mejor, pues no, no es la mejor ni de coña porque aunque sí

es cierto que no hay contexto (yo tampoco lo tengo), no se puede optar por una

traducción como la aquí dada


  • Incluso en el caso de Mistral que en mi opinión se aproxima más tampoco logra a ceñirse al significado de los conceptos empleados en la oración:


Con todo esto ¿A dónde quiero llegar? ¿Se confiaría un trabajo histórico y riguroso sólo a una IA? ¿Dejamos de estudiar las lenguas clásicas y la historia porque una IA lo sabe todo ya?


Pues que la traducción que se nos vende muy habitualmente como que es un tema ya totalmente dominado por las IAs, creo que no lo está, si bien es cierto que para cosas sencillas, las soluciones no resultan malas hay que tener cuidado y un buen traductor siempre será bien valorado.


También levanto una lanza porque a quien le guste, que siga con los estudios clásicos y aprenda el sentido de las cosas, no podemos dejar en manos de la tecnología el lenguaje humano, perderemos todos si lo hacemos así. Ciertamente se ha producido un gran avance en todos los temas de lenguaje natural con estos nuevos modelos, pero si todo el mundo abandona el estudio serio de la lengua, la histroria, la filosofía, ... el mundo acabará siendo algo escrito por IAs, youtubers y charlatanes que balbucearán lo que la IA les diga y que no harán más que empobrecer la cultura humana, la cual no se adquiere de una forma sencilla, sino con esfuerzo y perseverancia en el estudio.


Por tanto, creo que durante un tiempo seguiré con mis estudios de griego clásico y desde luego me fiaré más del libro que mencioné y de otros que recomienden los profesores, no escritos por una IA, sino por gente de carne y hueso que saben (o supieron) de lo que hablan y espero que su criterio me ayude a conocer más tanto de esta materia, como de mi propia lengua, porque eludir la enseñanza de buenos profesores para que nos enseñen las IAs, creo que es un error garrafal que el tiempo desvelará.


Con esta parte finalizo la sesión dedicada a Series Temporales donde se ha construido desde un artilugio para recoger datos atmosféricos dados en mi jardín, la visualización de algunos de estos datos y ahora, con una muestra que va desde el 22 de Febrero hasta el 17 de Abril del 2026, me dispongo a tratar de crear algún modelo sencillo y a comparar los resultados con datos oficiales recogidos por la estación meteorológica de Pinar de Chamartín que está cerca de donde yo vivo.


Por tanto, voy a tratar de ser ordenado porque se va a trabajar con 2 tipos de información:


  • Información tipo I Mis propios datos donde hay sólo 3 variables que son temperatura, humedad y presión todas medidas cada 10 minutos y cuyo aspecto resulta ser el siguiente:


  • Información tipo II: Por otro lado para determinar la variable target y para hacer otras comparaciones, me he descargado la información de la estación meteorológica de https://meteostat.net/es/ donde puedes definir unas fechas y te descargas una serie de variables entre ellas estarían, a nivel diario varias de las que voy a considerar sólo las siguientes: la precipitación, la temperatura media y la presión media. No tomo la humedad, porque no existe esa variable (aunque se dan otras como la velocidad del viento y demás que por motivos de comparabilidad con los datos que tengo, no la usaré aquí aunque puseda ser relevante para un modelo más sofisticado) Así pues represento a continuación para el mismo período de antes la evolución de la temperatura y la presión media de los datos que se denominarán "oficiales" en este estudio:


Si se observa las variables comunes y consideradas son parecidas en comportamiento general, si bien cambian la escala de medición, sobre todo en el caso de la presión. En todo caso, la variable target sale del dato de precipitaciones que da la estación meteorológica considerada de modo que, si existe un valor de precipitación > 0 entonces target = 1 y en caso contrario target = 0 teniéndose por tanto 2 datasets con las siguientes estructuras:


En este caso las variables explicativa son: tmean_l1, pmean_l1, y hmeanl1 (siendo esta última sólo disponible en el dataset de "datos propios" no oficiales) mientras que la variable explicada en ambos conjuntos es target.


Por simplificar este análisis no se han añadidoi variables adicionales que podría por ejemplo extraer en mi caso como variaciones intra-dia, y en el caso de los datos oficiales podría haber considerado otras variables adicionales como ya he comentado, dejamos por tanto estas variables comunes para construir algunos modelos y ver qué es lo que pasa en tan corto período de tiempo.


Si se comienza analizando el dataset de mis propios datos bajo un modelo de regresión logística donde se usa el 90% de la información de las series temporales para entrenar y un escalado de las variables tal como sigue:


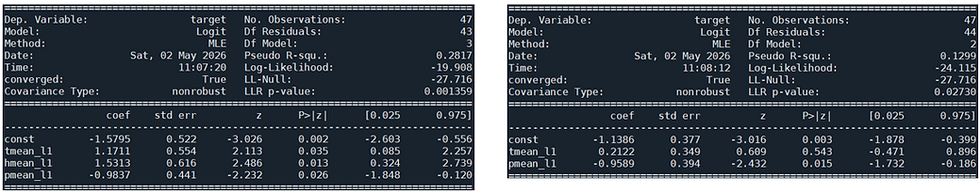
Se llegan a plantear los siguientes modelos:


En este caso se observa el hecho curioso de que si se elimina la variable hmean_l1 que es la variable que mide la media de la humedad del día anterior (y que no existe en el dataset anterior), entonces sólo la variable pmean_l1 o media de la presión del día anterior se torna como significativa. No obstante en ambos casos los signos de la regresión tal y como se puede observar resultan correctos y de interpretación directa.


¿Qué ocurre cuando se plantea el modelo con datos oficiales? En este caso se obtiene el siguiente resultado tras aplicar el mismo proceso:


En este caso el resultado, a nivel de conclusiones también indica que la variable tmean_l1 llega a ser superflua y no aporta significatividad al modelo, por lo que tanto con datos oficiales como con datos propios se llega a la conclusión que todo el mundo conoce y es que "bajas presiones anticipan lluvias, mientras que las altas presiones anticipan estabilidad o más bien ausencia de lluvia", sin embargo resulta curioso como la medición de la humedad está introduciendo un factor que usado junto con la temperatura permite un modelo con más variables significativas, por tanto, se van a considerar los siguientes 3 modelos que se denominarán "completo con datos propios", "común con datos propios" y "común con datos oficiales" todos con variables significativas tal y como se observa a continuación:


En todos los caso se observa que para el único día en el que hubo lluvia los modelos aciertan, mientras que mantienen elevada la probabilidad de lluvia para el día siguiente. También se observa en los "modelos comunes" que la significatividad de la variable presión media del día anterior tiene una significatividad parecida, si bien es cierto que la coherencia a nivel predictiva es mayor en el modelo con "datos oficiales" frente al de "datos propios"


En todo caso para ampliar las pruebas podría discutirse otros modelos como decision tree o incluso random forest. En los códigos de "versiones modelos" que cuelgo en el git:


Hay código para que adecuadamente modificado se pueda testear estas opciones con todas o parte de las variables, esa discusión no se hace aquí, pero resultaría interesante analizar al menos la actuación de los decision trees ya que para ir a un random forest sería recomendable un mayor volumen de información.


Por otro lado, el hacer uso de datos "intradía" nos podría permitir incluso usar más variables que desde un medio "oficial" no se nos daría al menos que se pagase por ellos, en el supuesto que lo tuvieran, por tanto, como conclusión finales caben destacar los siguientes:


  • Se ha logrado crear modelos que se podrían llevar a un entorno productivo bajo un proceso de retro alimentación continua que permitiesen un machine learning real mejorando la fiabilidad de las predicciones cuando se dispusiese de más datos con los que se podría crear de un modo sencillo un modelo que "aprendiese" de los datos


  • La información "oficial" es susceptible de ser completada con información "particular" como es el caso de la variable humedad y otras que se podrían crear basados en comportamientos intra día que pudieran influir en el comportamiento del día siguiente, por ejemplo "media de presiones durante las 6 horas previas al inicio del siguiente día"


  • Aunque ambos modelos parecen equivocarse en que en el día siguiente a la ocurrencia de la lluvia, debería haber llovido, no se tiene con certeza si fue un error o si la lluvia tuvo lugar durante unas horas que podrían ser consideradas cercanas o ya en el día siguiente, por tanto, es un error en este caso admisible


  • Por último se habría de tratar un poco sobre el ajusta de las "probabilidades de lluvia", aquí no se ha tratado mucho, pero convendría ir midiendo conforme pasa el tiempo cómo ajustar esas probabilidades a datos que permitan construir un sistema semafórico tipo rojo, amarillo, verde que indique mayor o menor riesgo de lluvia


Finalmente indicar, que frente a la moda de crear post basados en chat-gpt todo lo escrito aquí es totalmente personal si bien para el tema de los códigos que elevo, si he hecho uso de la IA donde en parte considero que me ha ayudado, si bien he tenido que estar muy pendiente de correcciones y errores graves que cometía a un nivel de versión avanzada.


En este ejemplo se describe cómo se puede adiestrar un robot fabricado bajo un entorno tipo Arduino para dotarle de un modelo autónomo. Se tratan varias partes que se pueden saltar, en función de lo que más interese y cuyo índice es el siguiente:


               Parte I: Hardware y coste

               Parte II: Conexiones

Parte III: Datos de entrada. El manual de conducción

Parte IV: Aprendiendo a conducir. El entrenamiento neuronal

Parte V: El código conductor

Conclusiones


Parte I: Hardware y coste.


Se describen los materiales y los costes aproximados que se necesitarían para este robot con indicaciones de donde se podrían adquirir:


  • Arduino Nano: Es el microcontrolador de todo, tiene un coste unitario de unos 4€ – 5€ y es fácil de encontrar en Aliexpress o Amazon

  • Placa soporte, yo opté por una circular de metal ya hecha que me pillé por Aliexpress a unos 2’6€ en https://es.aliexpress.com/item/1005008163755685.html?spm=a2g0o.order_list.order_list_main.138.43af194d9Se4ye&gatewayAdapt=glo2esp

  • Un controlador L298N que son fáciles de encontrar con un precio entre 2€ - 3€

  • Un mando a distancia con un receptor IR de infrarrojos, lo hay de varios tipos y casi todos funcionan igual, yo tomé uno de la marca elegoo, si se cambia de marca hay que reconfigurar o buscar los botones adecuados, en todo caso se puede eludir esto si se quiere un robot sólo de IA y se ahorraría también un montón de código. El coste ronda los 3€

  • Una protoboard pequeña que se pueden encontrar fácilmente por 3€

  • Tornillos, tuercas de unos 3mm y 4mm y ángulos de 90º para generar soporte tal y como se muestran en las fotos de más abajo, en total puede haber un coste de lo usado de no más de 5€ (comprando en lote es fácil de encontrar)

  • 2 ruedas con sus motores (yo tomé unas caras, pero dado que no controlo velocidades, se puede optar por motores más baratos sin cuadraturas), teniendo un coste de uno más de 4€ por Ali-express

  • Un servo (de 180 grados suficiente) que ronda unos 2.40€

  • Un sensor de ultrasonidos que rondará unos 2.5€ y es fácil de encontrar

  • Caja de 2 baterías lipo de 3.7V a 2.5V

  • Finalmente 3 leds, con 3 resistencias de 220V más cableado donde estimo un coste de unos 2€ máximo sabiendo que son materiales que se compran a granell


En total bajo un coste máximo aproximado de unos 40€ sin contar las baterías, yo cogí una de 5V para Arduino que tenía en casa y 2 pilas lipo recargables pueden costar unos 10€ si se busca bien se tendría algo parecido a:


Nótese que a pesar de que 40€ puedan parecer mucho, todas las piezas son reutilizables para otros futuros artefactos que nos pueda interesar crear, de hecho, muchas de dichas piezas las tengo de otros anteriores por lo que he tenido que comprarlas de nuevo.


Para finalizar esta sesión y dado que este post está enfocado al detalle de cómo incorporar Inteligencia Artificial al anterior artefacto, no ofrezco detalle de su montaje en la práctica, aunque tal y como se observa, no cuidé demasiado los detalles y marcha bien.


Parte II: Conexiones.


En todo caso, no se explica como montar físicamente el robot a nivel de apretar tornillos y demás, sino que en cambio se detalla cómo deben estar conectadas las componentes a muy alto nivel para que posteriormente se entienda cómo va a ser la incorporación de la “inteligencia” al artefacto:


Parte III: Datos de entrada. El manual de conducción


Tras montar el robot, hay que dar las instrucciones adecuadas al microcontrolador parra que:


  • En modo manual, que no se analiza aquí, el robot avance, retroceda y gire

  • En modo IA, el robot evite obstáculos cuando los detecte a una determinada distancia


Antes de dar el paso 2 que es el que se describe aquí, se construye un programa denominado SimulaRed.py que va a contener tanto simulaciones como los pesos que tomará el microcontrolador para generar un comportamiento adecuado, acorde al código.


Por tanto, esta parte trata cómo son los datos con los que se entrena el vehículo que están bajo la función generar_dataset, de la que se generan 4000 muestras siguiendo la siguiente regla:


for _ in range(n):

        dist = random.uniform(0, 40)

        angle = random.uniform(60, 120)

        if dist < SAFE_STOP_CM:

            if angle < 85:

                label = 2

            elif angle > 95:

                label = 1

            else:

                label = 3

        else:

            if dist > OBSTACLE_LIMIT_CM:

                label = 0

            else:

                if angle < 85:

                    label = 2

                elif angle > 95:

                    label = 1

                else:

                    label = 0


Que gráficamente responde al siguiente esquema:


Nótese que aquí está la clave, la red neuronal a entrenar va a aprender estas regiones del espacio y aunque el gráfico tiene cierta sencillez y podría aproximarse con un modelo tipo múltiple tree decisional, obviamente las reglas dadas anteriormente podrían ser refinadas con decisiones no lineales y en consecuencia el método no permitiría una “escala en inteligencia” que sí lo permitiría la red.


Por tanto, la red a diseñar tendrá que aprender los datos aquí presentados que básicamente es un manual de qué hacer cuando te encuentras un obstáculo a una determinada distancia bajo un determinado ángulo dado por el sensor de ultrasonidos que controla la distancia y el servo que controla el ángulo.


Parte IV: Aprendiendo a conducir. El entrenamiento neuronal


Los datos anteriores son la entrada de la función entrenar(), básicamente esta función entrena una red neuronal de una única capa oculta de 8 neuronas y una capa de salida de 4 neuronas siendo todas de tipo tangente hiperbólico y obedeciendo a 2 únicas entradas que son las de distancia y ángulo obtenidos de la combinación de los sensores anteriormente citados. Por tanto, se tiene la siguiente arquitectura de red:


Que como se puede observar (si se cuentan las flechitas) se tendría un total de unos 2 · 8 + 8 · 4 = 48 pesos neuronales que van a intentar, tras ejecutar esta función y aplicar unas 80 iteraciones o epochs replicar el anterior espacio.


Como puede observarse en el código, se entrena todo desde el scratch sin hacer uso de la librería sklearn, siendo clave las siguientes líneas:


h = [math.tanh(sum(xi[j] * W1[j][i] for j in range(2))) for i in range(hidden)]

o = [math.tanh(sum(h[j] * W2[j][i] for j in range(hidden))) for i in range(out)]


Que básicamente resumen la dinámica de la red donde aplican primeramente el movimiento forward o hacia delante de la red para finalmente concluir con una variante tipo backpropagation tratando de minimizar una función de error tal como:


sample_loss += (target[i] - o[i])**2


La opción elegida y aunque no es la óptima, teóricamente ofrece una rápida caída del error y al final alguna muestra de overtraining tal y como se observa en la salida gráfica tras ejecutar la función:


Cabe preguntarse por tanto ¿Y si se hubiera hecho un backpropagation estricto en vez de estas simplificaciones que buscan evitar el derivar? ¿Y no cabría usar la librería de redes de sklearn? Todo esto serían interesantes ejercicios que darían finalmente una serie de pesos a implementar en alguna red neuronal que puede ser como ésta, de sólo tanh y una única capa oculta con 48 parámetros o algo más elaborado.


Además, el código .py que genera tanto los siguientes pesos:


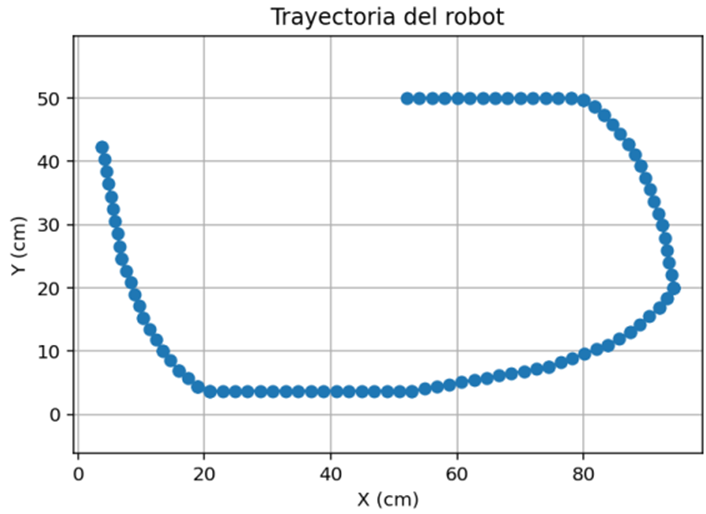
Como una posible simulación de una trayectoria para testear que el robot no se queda atascado tal como sigue:


Tiene la suficiente versatilidad para que una vez visto, que genera un movimiento relativamente estable, se pueda extraer la función de la red con los pesos entrenados, este código puede encontrarse en el git:


Parte V: El código conductor


El código final, que va al microcontrolador es un código .ino que se encuentra junto al fichero .py en la ruta anterior.


Este código, aparte de conectar entre sí las componentes hardware, permite integrar la salida de la red a través de un área donde se “cortan y pegan” los pesos obtenidos del código .py:


Y dichos pesos son resueltos mediante la función decidirAcción() donde cabe destacar la parte donde se aplica la red neuronal quedando todo bastante resumido gracias al uso de las operaciones vectoriales adecuadamente utilizadas:


Conclusiones


Con lo construido hasta aquí se tiene una aplicación práctica y directa de un red neuronal aplicada al movimiento autónomo de un robot.

Se ha tomado este caso sencillo con claro objetivo didáctico, pero cabe hacer ejemplos más elaborados e incluso variantes que pueden resultar bastante óptimas, si bien, la opción aquí escogida permite tener la red totalmente descompuesta en sus elementos y por tanto pueden ser manipulados frente a una función de una librería que puede quedar más ocultos o difíciles de descifrar ya que Arduino no acepta Python y por tanto todo debe ser pasado a C y claramente, una fórmula matemática, aunque pueda ser larga, es perfectamente resoluble tal y como se puede comprobar.


Finalmente, un vídeo con el resultado se tiene también en la dirección de git siguiente:


© 2021 by Francisco J. Rodríguez Aragón. Proudly created with Wix.com

bottom of page